Según el Data Breach Investigations Report (DBIR) 2026 de Verizon, la explotación de vulnerabilidades ya es el vector de acceso inicial número uno: 31 % de las brechas, superando por primera vez al abuso de credenciales. Al mismo tiempo, la mediana de tiempo de parcheo subió de 32 a 43 días, y solo el 26 % de las vulnerabilidades del catálogo KEV de CISA quedó completamente corregido.
Las empresas no sufren brechas por falta de herramientas, sino por parchear a ciegas.
El problema: CVSS mide severidad, no probabilidad
El puntaje CVSS mide la severidad técnica intrínseca de una vulnerabilidad, no la probabilidad de que sea explotada en tu entorno. Si tienes 100 alertas “Críticas” pero tu equipo solo puede aplicar 10 parches esta semana, priorizar solo por CVSS es jugar a la ruleta rusa.
EPSS ayuda, pero entrega una probabilidad estática a 30 días: no modela la dinámica temporal ni los flujos de detección y mitigación bajo una capacidad operativa limitada.
Qué es Cyber-Prioritizer
Para resolver ese cuello de botella creé Cyber-Prioritizer: un motor matemático de gestión de vulnerabilidades basada en riesgo (RBVM) que traduce telemetría aislada en decisiones ejecutivas.
No busca reemplazar a NVD, CVSS o EPSS, sino orquestarlos: toma esas métricas técnicas aisladas y las convierte en un orden de parcheo que reduce horas-hombre y evita parchear vulnerabilidades sin probabilidad real de explotación.
- Integra inteligencia real: cruza tu inventario con NVD, EPSS (FIRST) y el catálogo de explotación confirmada de CISA (KEV), con mapeo táctico MITRE ATT&CK.
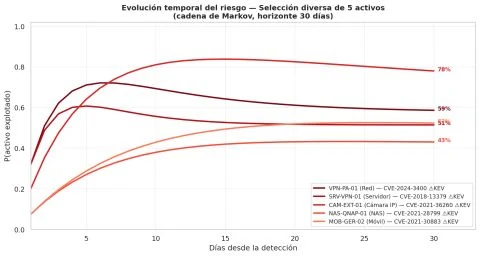
- Modela el tiempo: usa Cadenas de Markov para proyectar la probabilidad de compromiso a 30 días.
- Optimiza el presupuesto: selecciona el subconjunto de K activos que maximiza la reducción esperada del riesgo dinámico.
La metodología en 4 pasos
- Probabilidad real. Convierte el puntaje EPSS en una tasa diaria de explotación:
p_e = 1 − (1 − EPSS)^(1/30). - Cadena de Markov por activo. Cada activo se modela con una matriz de transición de 4 estados — Seguro, Detectado, Explotado, Mitigado — para proyectar su probabilidad de compromiso en un horizonte de 30 días.
- Riesgo dinámico. Pondera esa probabilidad con la criticidad de negocio del activo y su exposición de red (Internet, DMZ o red interna).
- Optimización bajo restricción. Asigna los K parches disponibles donde más riesgo residual eliminan.
Resultados: mismo presupuesto, más riesgo eliminado
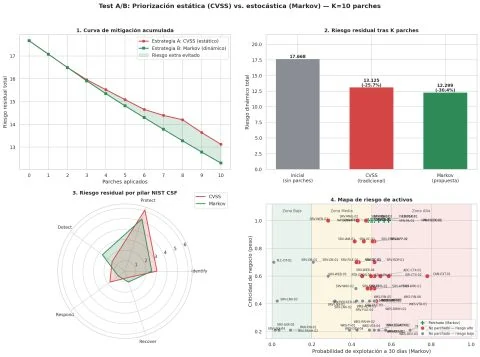
En un entorno simulado de 68 activos heterogéneos y una restricción de 10 parches, ambas estrategias coinciden en 5 activos y difieren en los otros 5. Ahí está toda la diferencia.
El criterio CVSS gastó 3 parches en la misma vulnerabilidad (Log4Shell) en tres instancias distintas y 2 en activos de criticidad Media, solo porque marcaban 10.0. El modelo estocástico redirigió esos 5 parches a vectores de acceso real: Citrix NetScaler, Fortinet FortiOS, dos Exchange y Apache HTTP, todos en KEV, de criticidad Alta y expuestos a Internet.
El patrón se repitió en un segundo inventario independiente de otro sector: 60,3 % vs 47,6 %.
Lo que el modelo no resuelve por sí solo
Sin una línea base de inventario homogénea, cualquier plataforma de RBVM, por costosa que sea, produce ruido.
Por eso el repositorio incluye una plantilla de inventario (/data/Formulario_Inventario.xlsx) con parámetros prellenados que mantienen la homogeneidad de la carga y evitan fallas del algoritmo.
Cyber-Prioritizer es un MVP académico y de código abierto, diseñado para demostrar la viabilidad metodológica del modelado estocástico. La arquitectura de microservicios y colas asíncronas para escala masiva está en desarrollo para la versión enterprise de IKUBERT.
Cómo probarlo
- Entra al repositorio en GitHub y abre
notebooks/Cyber_Prioritizer.ipynben Google Colab o Jupyter. - Ejecuta las celdas con la matriz simulada, o carga el inventario de tu organización usando la plantilla de
/data. - El notebook genera el test A/B y exporta reportes ejecutivos (Markdown, HTML, DOCX) y grillas operativas en XLSX para SecOps.
Licenciamiento dual
El código se publica bajo GNU AGPLv3 para uso académico, personal y proyectos abiertos. Las organizaciones que necesiten integrarlo en plataformas propietarias o servicios gestionados, o que por compliance no puedan cumplir los términos de la AGPLv3, pueden solicitar una licencia comercial a través de IKUBERT ([email protected]).
La pregunta para tu equipo
¿Cómo priorizan hoy cuando el backlog de críticas supera la capacidad del equipo? ¿CVSS, EPSS o criterio del analista?
Si quieres aplicar este enfoque a tu propio inventario, es exactamente lo que hacemos en la fase de priorización del framework IKU-Risk™.
Fuentes: Verizon DBIR 2026 · SecurityWeek: Vulnerability exploitation overtakes credential theft · Tenable: Key findings from the Verizon DBIR 2026 · Industrial Cyber: KEV remediation